罗佳
本教程目录:
一、个人需求拆解
二、运行逻辑拆解
三、SKILLS 创建和使用
四、元 SKILLs 以及 全流程总结
前言
书接上文,
你的无休助理 OpenClaw Windows使用保姆级教程(一)丨安装部署、免费额度和飞书连接
你的无休助理 OpenClaw Windows使用保姆级教程(二)丨赋予独一无二的性格、灵魂和边界
我们的助理潜力很大,但现在它还并不强大。根据你的需求,你需要让你的助理掌握不同的手艺和技能去干你要求的事情,对我们而言,这个「手艺」就是Skills,多一个 Skill 就相当于你的 AI 助理多了门手艺。
而对 AI智能体 而言 Skills 其实就是一份「操作文档或手册」,如果你需要让你的 AI 助理查资料、写代码、或者控制电脑操作, AI智能体会读取并按照这个文档中记录的指令、命令行、甚至可执行的脚本等等执行操作。
这样的讲法依然比较抽象,所以本篇教程我们将用一个实例「让电脑帮我我们查询资料并在本地创建资料库」来理解 SKILL 。
来源:rodya.top/articles/skill-demand-driven-creation · 罗佳 Rodya 原创
一、个人需求拆解
现在我们举个具体的例子,我需要让我们的AI助理在新闻网站找陕西经济相关的文章,整理总结后再本地建立资料库,以备我查找使用。
拆解这个需求:
1、首先是去哪找。我的诉求是希望我的 AI 助理去某个我指定的网站查询或者让它自行用搜索引擎寻找。
2、其次是找什么。我的诉求我的 AI 助理要按照我的要求去找,我需要指定某个特定的话题。
3、找到了干什么。我的诉求是我的 AI 助理在找到资料后或者按照主题或者按照时间等我的指定的方式总结归纳,在本地按照相应的逻辑建立知识库。
4、我显然希望将上面的流程打包成为一个可以复用的 SKILL,当我使用特定命令它能按照这个流程询问我的需求,在我确认后去执行。
二、运行逻辑拆解
当我们的 AI 助理收到我们的指令「去新闻网站查找整理陕西相关的资料」时,它会立刻开启一个思考 -> 调用工具 -> 观察结果 -> 再次思考 的智能循环。
大脑规划(思考): 我们用API配置的大模型会阅读你的指令和查找是否有相关 SKILL,然后决定第一步该干什么。
工具执行(调用):
大模型发指令给 OpenClaw:“用
web_search帮我找某新闻网站的网址。”OpenClaw 搜到网址后,大模型再次下令:“用
web_fetch把这些网址里的正文读出来,提取出发布年份。”
- 本地存盘(写文件):大模型将提取出的年份和排版好的正文,发送给 OpenClaw 的本地文件管理工具:“在
D:\MyAgent\陕西\年份\下新建 Markdown 文件,把内容存进去。”
然后,大模型会自动对搜到的每一篇文章重复第 2 和第 3 步,直到全部归档完成。
可以看到:
OpenClaw 的 web_search、web_fetch 以及我们刚才写的新建文件夹、保存 Markdown操作,本质上都是工具调用。Openclaw的内置工具 web_ search 负责找资料,web_fecth 负责处理找到的网页。
当 OpenClaw 收到你的指令时,它并不是自己在干活。它会把你的话,连同它拥有一堆工具(比如搜索、读写文件)的说明书一起发给大模型。
所以我们前面提到:SKILL 本质其实只是一个说明文档。现在我们正式开始,直接和我们的 AI助理去沟通整个过程。
来源:rodya.top/articles/skill-demand-driven-creation · 罗佳 Rodya 原创
三、SKILLS 创建
首先,我们配置一下我们的大模型,就像上面的流程说的当 OpenClaw 收到你的指令时,它并不是自己在干活。它会把你的话,连同它拥有一堆工具(比如搜索、读写文件)的说明书一起发给大模型。 大模型必须具备一种特殊的能力:它不仅要能理解你的意思,还要能按严格的 JSON 格式回复一段“机器指令”,告诉 OpenClaw:“现在,请你执行 web_search 工具,参数是 XXX。”
所以好马配好鞍,我们先给我们AI助理配一个好模型(暂时以国内模型为例子)。以本系列教程用的硅基流动(我们配置API的那个网站)为例子,(如果你使用的别的网站提供的API,流程大概类似)。
我们使用Pro/MiniMaxAI/MiniMax-M2.5 这个模型。打开网站,复制模型名称。
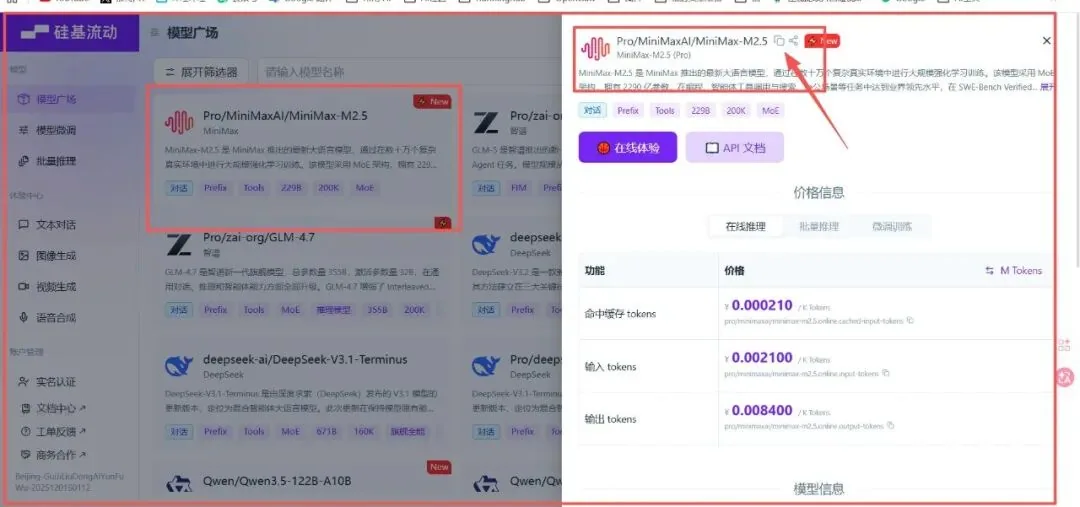
在左边新建 API。
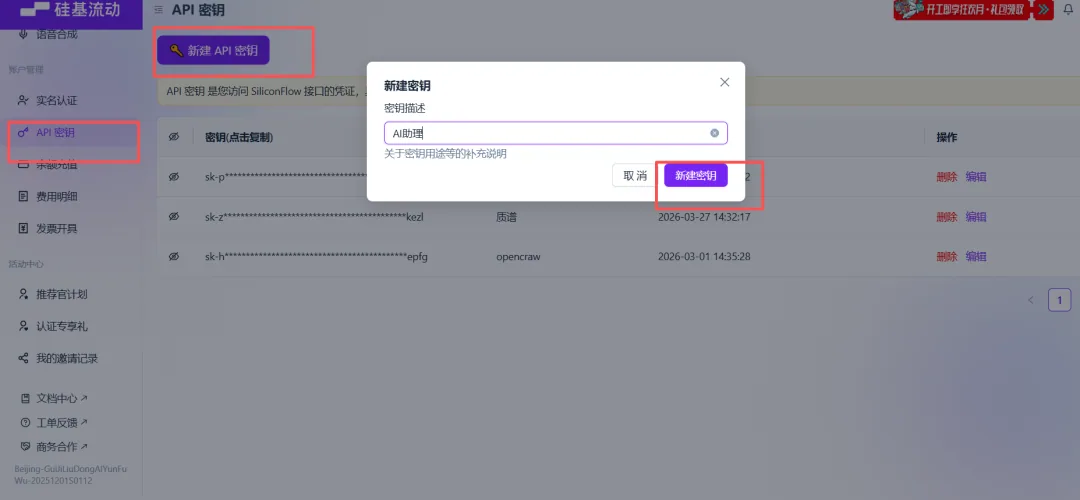
复制API。

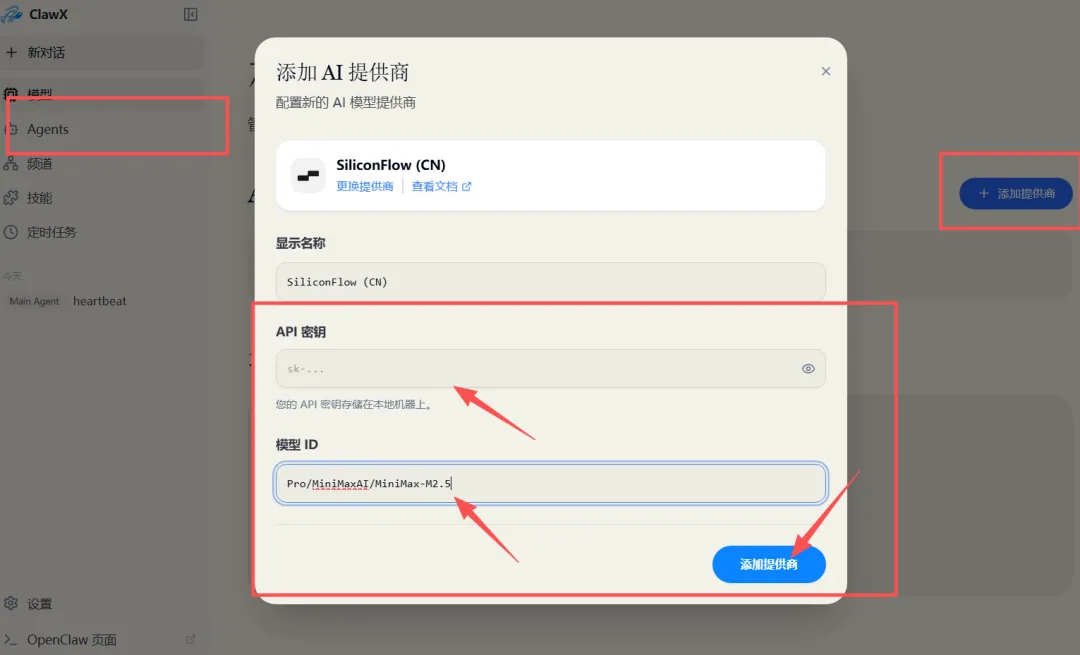
打开我们的ClawX 或者你用的图形化界面,点击模型,点击添加供应商,依次填入我们复制的API和模型,重启openclaw 就好了。
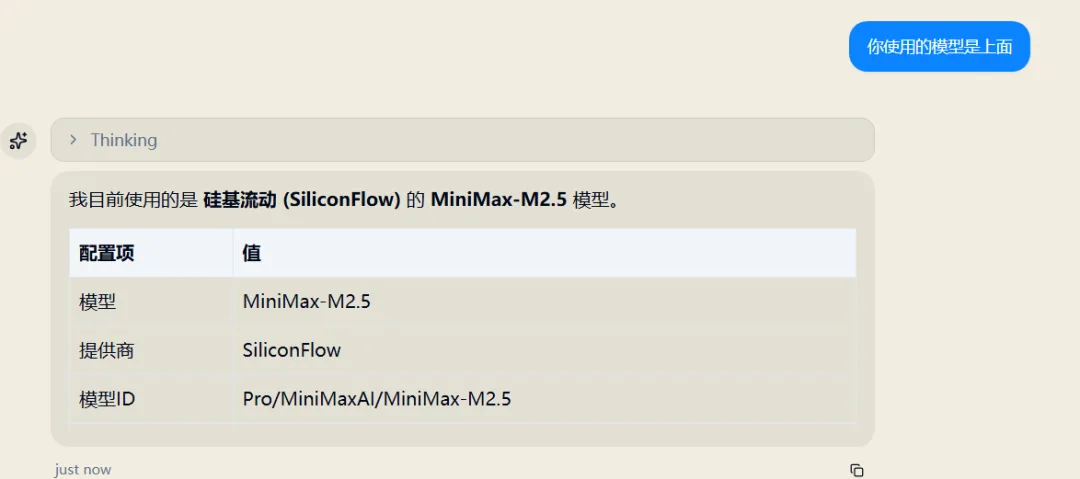
我们询问一下openclaw。
然后正式开始我们的流程。直接对我们的助理发送下面对话,(我们只是举例。)确定我们的需要:
帮我设计一个搜索整理资料并在本地建立资料库的SKILL,创建的SKILL保存在XXX(你需要保存电脑路径比如:D:\MyAgent)
然后等待我们AI助理的回复。
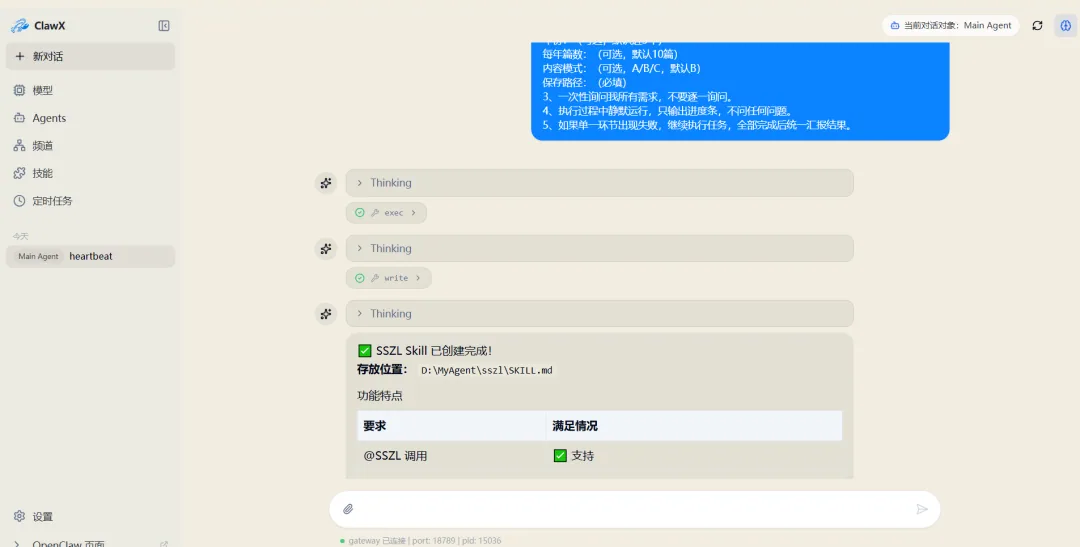
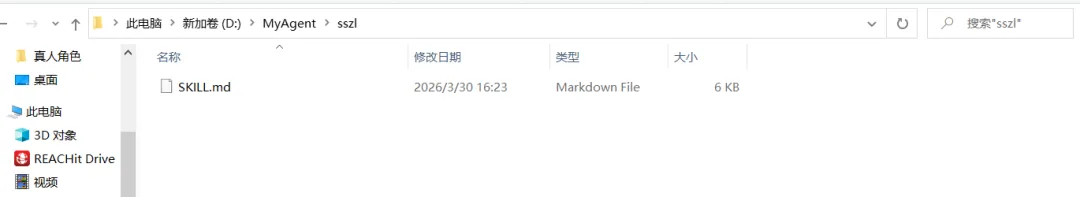
一般来说,他会创建一个sszl的文件夹,点进去是创建好的SKILL.md,这是 skill 的标准格式。
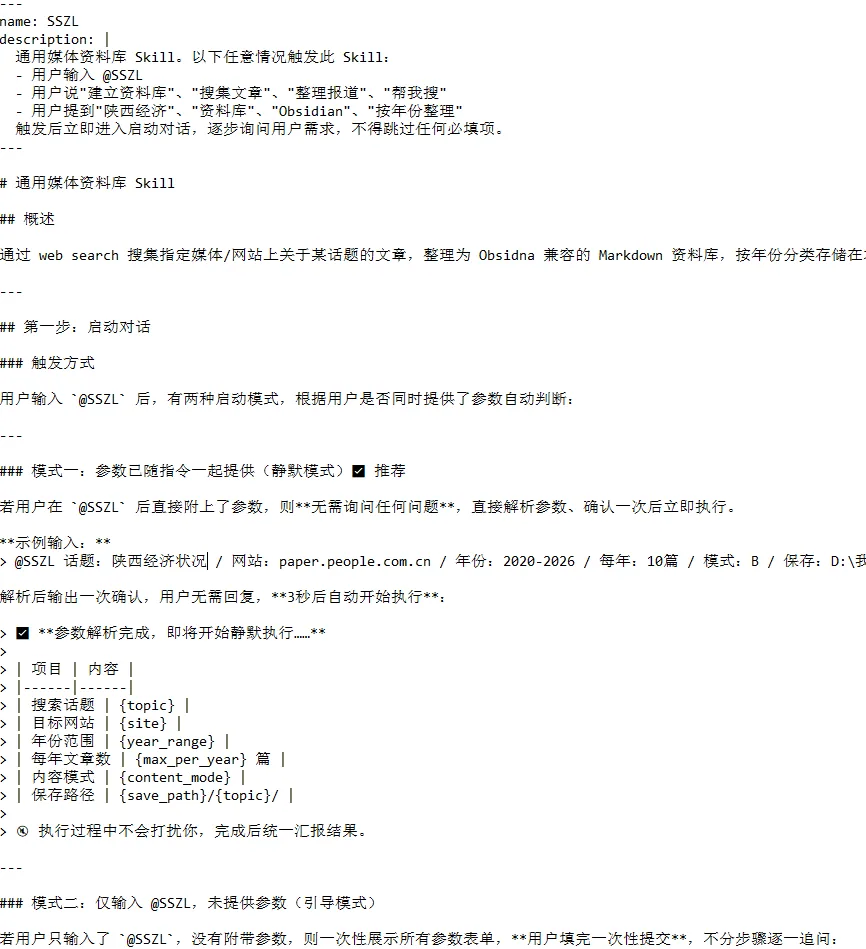
SKILL.md本身的内容是这样的(只截取部分,每个人的可能有差别),它确确实实其实就是一个写满我们的需求的文档:
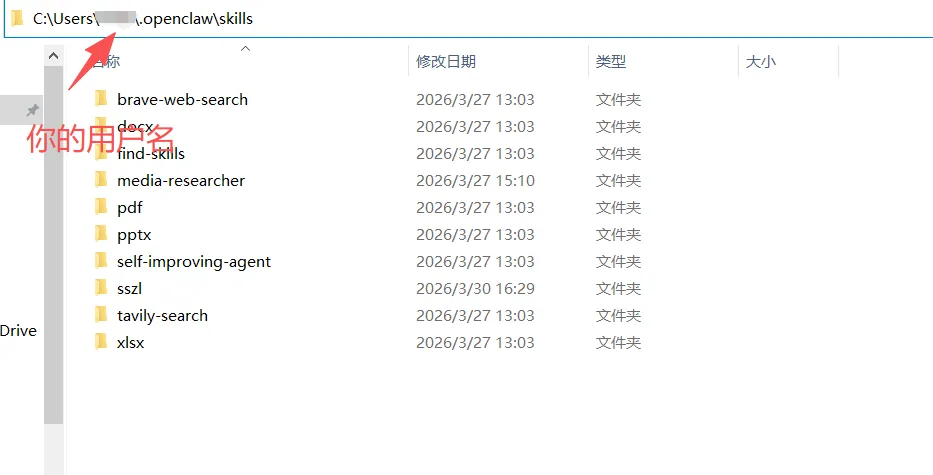
我们将这个文件夹放到 openclaw 的skill文件夹中,这里是专门存放sikll的地方。你也许会问为什么不让openclaw直接创建到这个地方,其实应该是这样的。但因为我们有时候会从别的什么地方下载到的SKILL.md,本文就是为了演示这个过程,
你可以复制你下载的skill,然后手动复制放在这里。
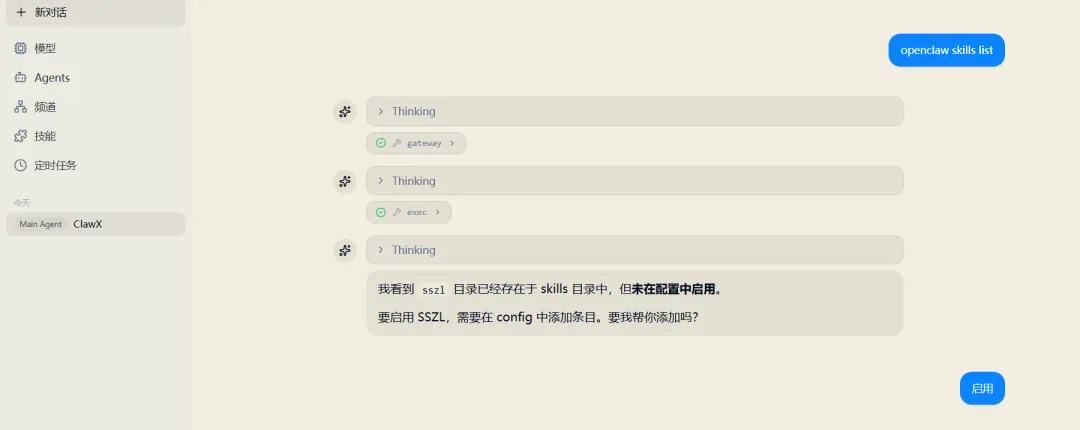
重启ClawX,询问,并且启用这个 SKILL。
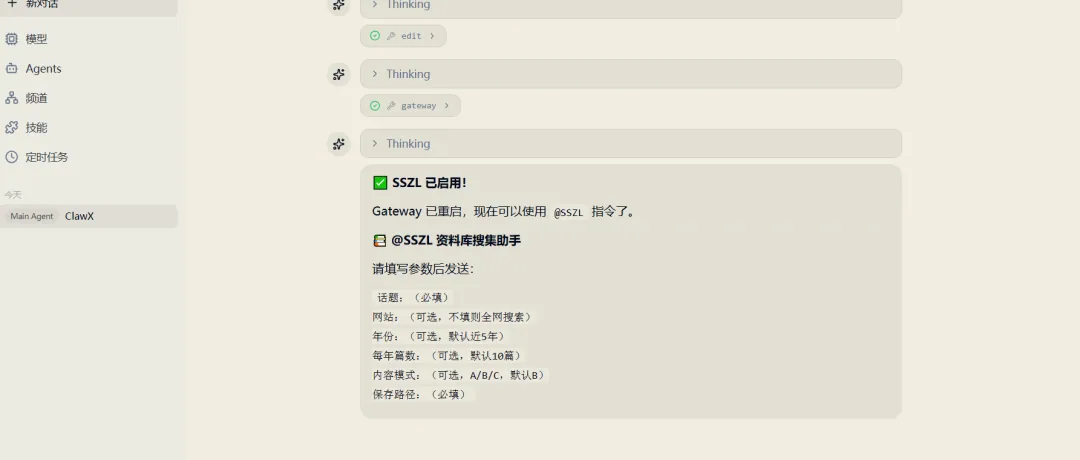
我们输入@SSZL,我们的SKILL 已经可以开始使用了。
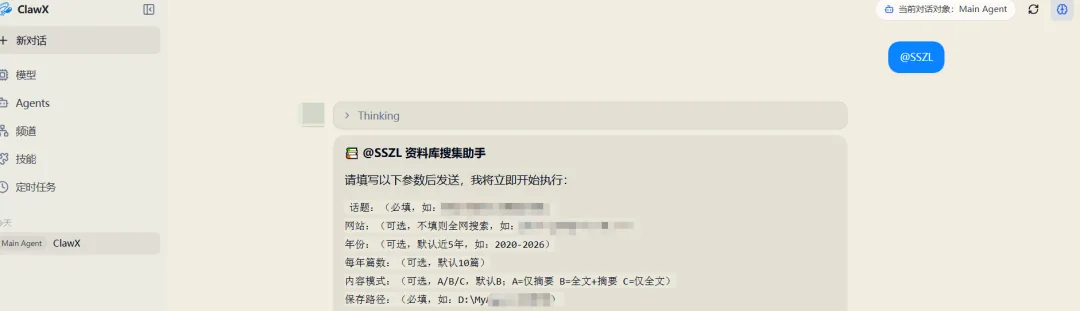
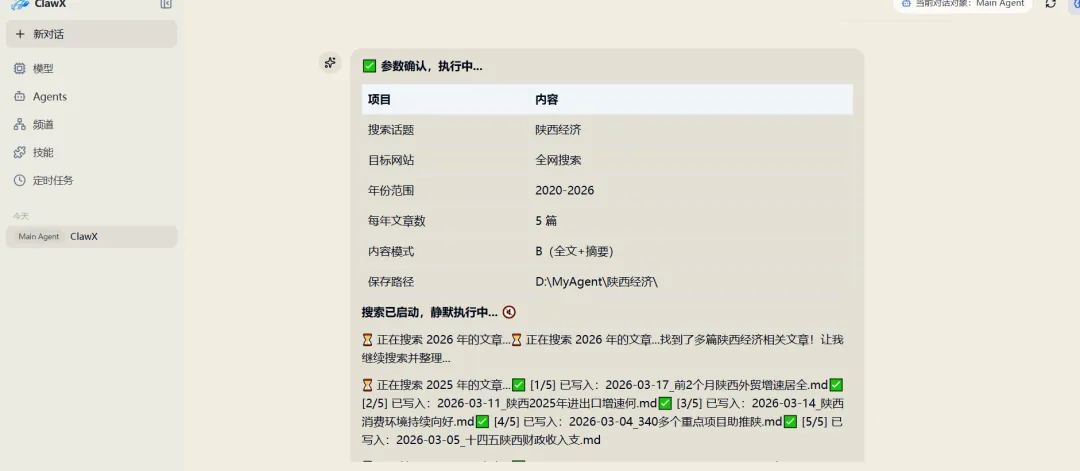
填入我们的需求发送,Openclaw 已经开始工作:
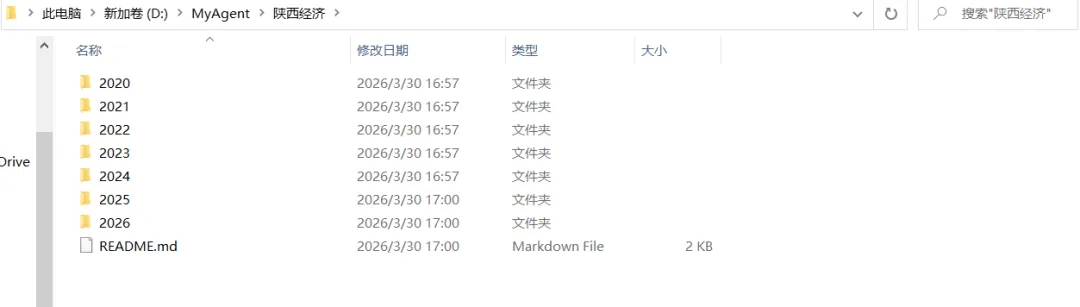
打开本地文件夹看一眼:
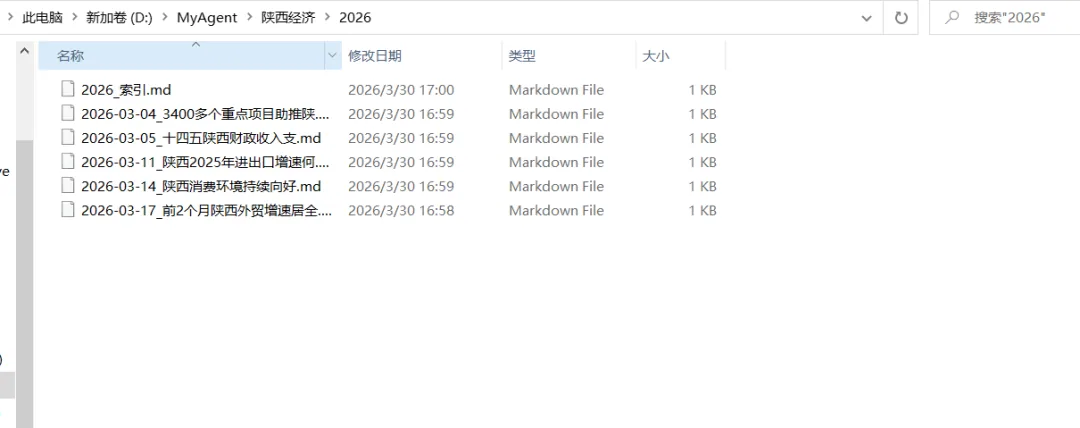
我用我的obsidian打开,(你可以使用记事本打开)
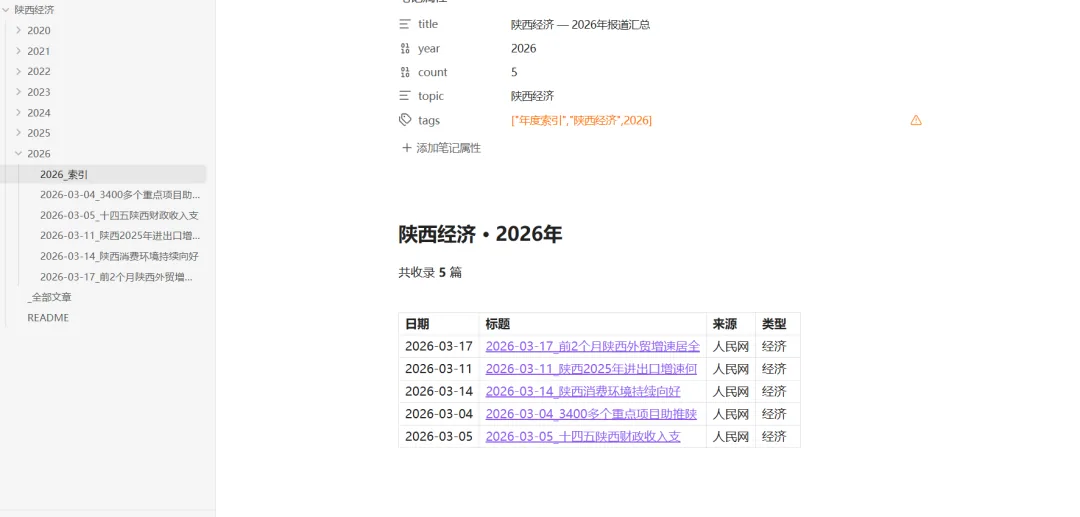
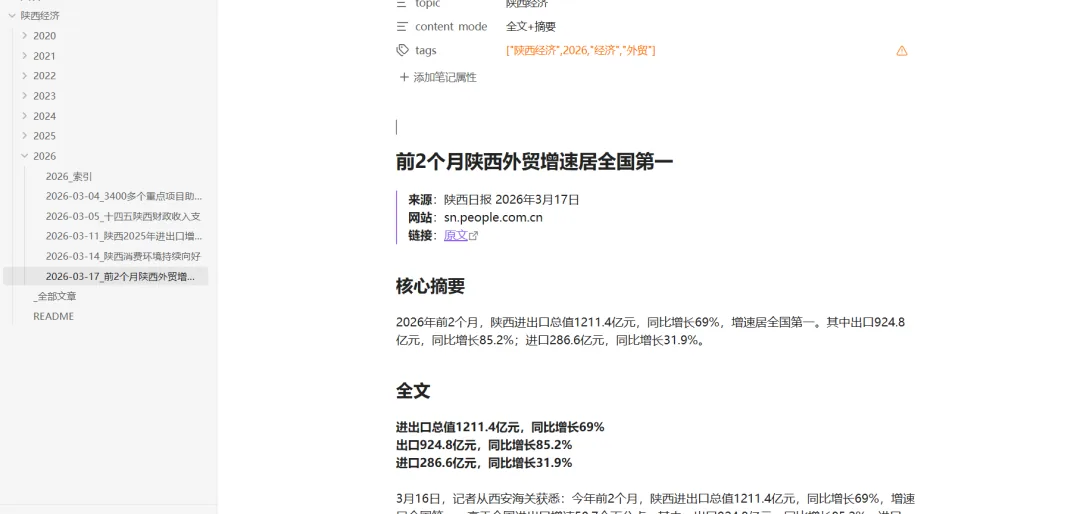
干的不错似乎。
这样我们就完成了一次SKILL的创建使用全流程。
四、元 SKILLs 以及 全流程总结
当然,我们整个流程的设计是非常简陋的。
比如,需求是我们自己提交给AI,我们也可以让AI继续挖掘我们的需求。又比如,我们并没有做自我检查迭代。又比如我们用的openclaw自己内置的web search 和 fetch功能,显然比较简陋。又比如没有做token节省等等需求。又比如对文件夹的排版我们没有具体要求。又比如我们的skill也许有一天要用在别的 Agent,怎么保证这个设计不但本身能复用,而且在任何 Agent 都能用。
等等需求。
而且我们完全可以把整个流程抽象成一个元SKILL让AI帮我们设计迭代整个流程,也就是一个创造 skill 的SKILL。不过这又是另一个话题了。
下一篇教程我们分享一些常用的 skill 以及去哪找 skill,基本就是本次系列教程的最后一篇了。
风骨