罗佳
两个月前写过文章,来介绍如何配置记忆系统 更完美的记忆系统:让 AI 越用越懂你丨实践手记 · 05 , 今天来聊一下如何配置长期项目的记忆系统。
一、一些误区。
对于那些长期项目,让 AI 真正记住我们的项目进展,方向计划和踩坑记录,需要一套跨对话的记忆系统,而不是依靠上下文压缩,交接文档,以及CLAUDE.md。
1、上下文是工作台,不是记忆
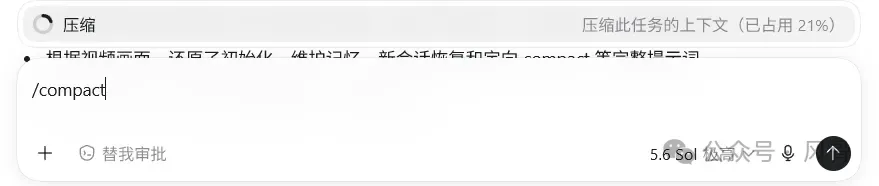
上下文压缩是用来给当前对话腾出空间,是有上限,而且会损失细节的。无论是codex 还是 claude的上下文压缩 /compact:他们做的事情都是把前面的对话替换成一份更短的结构化摘要,让当前会话还能继续。但它依旧是摘要。
原始材料里有 100 个细节,第一次概括留下 60 个,第二次可能剩 40 个,第三次继续减少。
它很像一张图片被反复截图、转发、再截图。每一轮都还能认出来,但边缘越来越糊,细节越来越少。
所以 /compact 适合解决「这个对话还要继续,但空间不够了」。尽管你也可以主动控制压缩,但它不是记忆。
/compact 重点保留当前目标、已修改文件、关键决策及原因、失败方案及证据、未解决风险和下一步验证计划。删除闲聊、重复输出、过时计划和已经失效的尝试。
来源:rodya.top/articles/long-term-project-memory-system · 罗佳 Rodya 原创
2、handoff:给下一棒说明现在跑到哪
我们在上一篇文章也提到 分享几个常用且实用的 AI 使用技巧丨ChatGPT Codex 边做边学 · 实用主义教程(07) handoff 适合一次性交接。
比如现在做到哪里、哪些测试没过、修改了哪些文件、下一步先做什么。
但如果第十个对话只能看到第九个对话写的 handoff,第九个又只看过第八个写的 handoff,本质上仍然是多轮转述。
早期细节会一轮一轮地掉。
3、CLAUDE.md / `AGENTS.md:给 AI 立长期规矩
这类文件适合保存每次会话都要遵守的内容:项目是什么;目录怎么组织;哪些操作禁止做;文件如何命名;完成任务的验收标准是什么。
它们不适合保存:今天排查了什么;某个临时方案为什么失败; 一个 Bug 目前查到哪一步;下周准备继续验证哪条路径。
如果把这些流水账全塞进去,几个月以后,你只对 AI 说一句「你好」,它也要先读完几千行陈芝麻烂谷子。
规则越多,真正重要的规则反而越难被看见。
上面三个都有各自发挥作用的场景,但不应该把它们当作长期记忆。
来源:rodya.top/articles/long-term-project-memory-system · 罗佳 Rodya 原创
二、一些经验
我自己的知识库是长期使用维护,我使用四层记忆来维护。
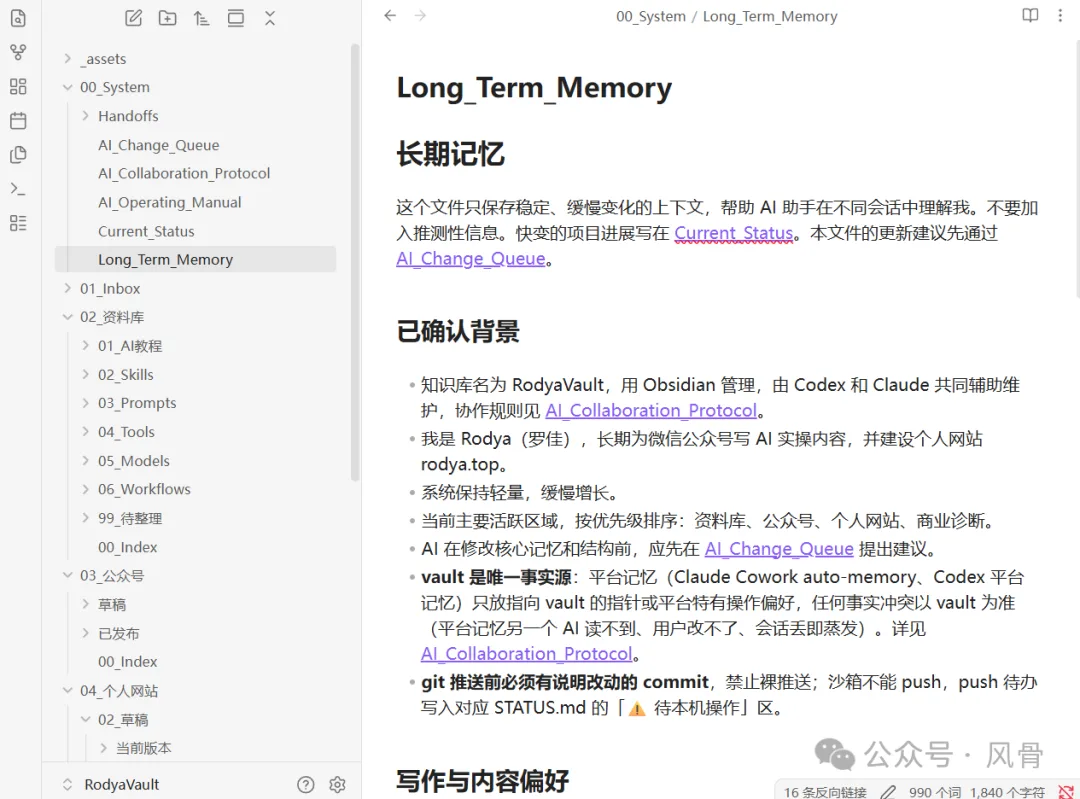
第一层:稳定记忆。
文件是:Long_Term_Memory.md。
只放三个月以后大概率仍然成立的内容,例如身份、写作偏好、长期工作方式和已经确认的规则。
这层回答的是:我是谁,我长期怎样做事。
第二层:当前状态
文件是:Current_Status.md
这一层只回答一句话:我现在正在做什么,下一步从哪里接上。
它只做跨项目仪表盘:最近在推进什么、哪些事情已经完成、下次会话最需要知道什么。我给它设了一个 80 行的硬预算。超过就压缩、外迁或归档。
第三层:项目记忆
每个长期项目单独维护 STATUS.md和 DECISIONS.md。
STATUS.md 放现状、待办和认领状态。
DECISIONS.md 放关键决定,以及当时为什么这样决定。
这层回答的是:这个项目走到哪里,哪些决定不能被随便推翻。
第四层:证据和历史
原始资料、归档、变更队列和 Git 保存完整证据。
前面三层只保留当前有效的结论。需要追溯「事情为什么变成这样」,再回到这一层。
这层回答的是:如果结论有争议,去哪里查原始证据。这套系统有一条最重要的纪律:一个事实只住一个地方,其他位置只放链接。同一件事复制三份,看起来更保险,实际上只会得到三个逐渐不一致的版本。
你可以使用下面的提示词初始化你的记忆系统。
请一次性检查、创建并安装本项目的四层记忆系统。先识别工作区根目录,阅读现有的项目指令、记忆文件、长期项目目录、STATUS.md、DECISIONS.md、归档和 Git 状态;不要直接覆盖已有内容。
如果你没有持久化文件写入权限、无法确认下次会话能读取这些文件,或没有项目级规则文件,请先明确说明限制与建议方案,不要假装已经完成。
确认具备条件后,先创建所有缺失的层与最小文件骨架;已有文件只增量整理,不覆盖:
1. 稳定记忆层:<工作区根目录>/Long_Term_Memory.md。2. 当前状态层:<工作区根目录>/Current_Status.md。3. 项目记忆层:为每个已识别的长期项目创建缺失的 STATUS.md 和 DECISIONS.md;不要为了凑结构创建空项目目录。4. 证据与历史层:确认原始资料位置、归档目录和变更队列文件可追溯;缺失时创建 <工作区根目录>/90_Archive/ 和 <工作区根目录>/00_System/AI_Change_Queue.md。若已有 Git 仓库,记录其为证据来源;若没有,不要凭空初始化 Git 或伪造历史。
然后,把下面的工作纪律写入本项目每次会话都会读取的规则文件(优先更新已有 CLAUDE.md、AGENTS.md 或项目规则,不要重复创建互相冲突的规则):
1. Long_Term_Memory.md 只保存稳定、已确认的长期事实;写入前检索,冲突时更新旧记录。2. Current_Status.md 只保存当前有效进度与下一步,保持在 80 行以内;每个任务阶段结束或准备换会话时自动更新。超过 80 行时,项目细节外迁到对应项目的 STATUS.md,关键理由外迁到 DECISIONS.md,已结束过程归档;仪表盘只留一句当前结论和链接。不得为了压缩删除仍影响下一步的结论或原始证据。3. 每个长期项目用 STATUS.md 维护现状,用 DECISIONS.md 维护关键决定、依据、备选方案和重评条件;出现重要决定或状态变化时自动更新。4. 原始资料、测试结果、归档、变更队列和 Git 是证据层;证据不足时必须说「没有记录」或「待核验」,不得根据印象补全。5. 一个事实只住一个地方,其他位置只保留结论和链接;不得写入密码、密钥、Token、Cookie 或其他秘密。
完成后请:1. 用四层清单列出每层的路径、已存在/本次创建状态和各自规则;2. 列出读取过的现有文件,以及本次创建、修改、归档了哪些文件;3. 展示自动更新会在什么事件触发;4. 列出发现的重复、冲突、敏感信息或需要我确认的问题。
这段只需在第一次搭建、迁移工作区,或发现规则已经失效时使用。它会按照我们的规定来进行自动化的流程:
- 任务阶段结束或准备换会话:更新 Current_Status.md;
- 长期偏好、固定规则真的变化:更新 Long_Term_Memory.md;
- 做出会影响后续工作的关键选择:更新 DECISIONS.md;
- 新证据出现、结论有争议或风险较高:回到证据层核验,并更新相关结论。
当然,我所写的也只是经验,在运行一段时间或者每个月你都可以发送和AI 沟通优化你自己的记忆系统。
请对我的四层记忆系统做一次「月度体检与个性化优化」,检查四层记忆的健康状况,依据可追溯的重复证据:我至少三次明确提出的偏好、我反复纠正的问题、我持续采用的工作流程,或有文件/反馈支撑的稳定做法等识别真正属于我的工作习惯先写成「待我确认」,不要直接升级为长期规则。按「四层健康状况、已完成优化、待我确认的候选习惯、发现的风险或冲突、下月建议」五部分汇报。同时列出每个被创建、修改、外迁或归档的文件,以及更新前后的行数/大小;最后用不超过 5 条列出本月真正值得保留的长期经验,如果没有,不要凭空捏造。
三、不同记忆系统的交集
不同 Agent 的记忆实现并不一样。
有的使用向量检索,适合从大量资料里做模糊召回;有的只维护一个记忆文件,适合小项目;有的像 Claude Code 一样,使用小索引加主题文件。
所以真正值得迁移的,不是某个产品的目录名,而是这套纪律:
- - 记忆分类;
- - 写入前去重;
- - 新结论覆盖旧结论;
- - 错误内容及时删除;
- - 索引保持有上限;
- - 原始证据保留在可追溯的位置。
你可以和你 AI 直接沟通探索,直到找出符合自己的项目的记忆系统。
四、最后
真正能让 AI 越用越懂你的,不是一段永远不结束的长对话,而是一套由你掌控、能被检查、能被修改、也能被删除的长期记忆。
因为好的记忆系统,不只要告诉 AI 它知道什么。还要让它知道:哪些事情,我没有记住,需要回去查。
收录于AI 工具教程
作者提示: 个人观点,仅供参考